def _classifier(kind, seed):
    if kind == "logit":
        return LogisticRegression(max_iter=400)
    if kind == "rf":
        return RandomForestClassifier(
            n_estimators=40, max_depth=4, min_samples_leaf=5, random_state=seed, n_jobs=1,
        )
    return GradientBoostingClassifier(
        n_estimators=30, max_depth=2, learning_rate=0.08, random_state=seed,
    )


def _regressor(kind, seed):
    if kind == "ridge":
        return Ridge(alpha=1.0)
    if kind == "rf":
        return RandomForestRegressor(
            n_estimators=40, max_depth=4, min_samples_leaf=5, random_state=seed, n_jobs=1,
        )
    return GradientBoostingRegressor(
        n_estimators=30, max_depth=2, learning_rate=0.08, random_state=seed,
    )


def dr_att(X, d, dy, learner="linear", seed=0, n_splits=2):
    """Doubly robust ATT for a first-differenced 2×2 comparison."""
    d = np.asarray(d, dtype=int)
    dy = np.asarray(dy, dtype=float)
    X = np.asarray(X, dtype=float)
    if X.ndim == 1:
        X = X.reshape(-1, 1)
    n = len(d)
    e_hat = np.full(n, float(d.mean()))
    mu0 = np.full(n, float(dy[d == 0].mean()) if np.any(d == 0) else 0.0)
    kind_c = {"linear": "logit", "rf": "rf", "gbr": "gbr"}[learner]
    kind_r = {"linear": "ridge", "rf": "rf", "gbr": "gbr"}[learner]
    splitter = KFold(n_splits=n_splits, shuffle=True, random_state=seed)
    for fold, (tr, te) in enumerate(splitter.split(X)):
        if len(np.unique(d[tr])) < 2 or np.sum(d[tr] == 0) < 8:
            continue
        clf = _classifier(kind_c, seed + fold)
        clf.fit(X[tr], d[tr])
        e_hat[te] = clf.predict_proba(X[te])[:, 1]
        reg = _regressor(kind_r, seed + fold)
        ctrl = tr[d[tr] == 0]
        reg.fit(X[ctrl], dy[ctrl])
        mu0[te] = reg.predict(X[te])
    e_hat = np.clip(e_hat, 0.05, 0.95)
    p_hat = float(np.mean(d))
    psi = (d / p_hat - (1 - d) * e_hat / (p_hat * (1 - e_hat))) * (dy - mu0)
    theta = float(np.mean(psi))
    se = float(np.std(psi, ddof=1) / np.sqrt(n))
    rmse = float(np.sqrt(np.mean((dy[d == 0] - mu0[d == 0]) ** 2)))
    acc = float(np.mean((e_hat >= 0.5).astype(int) == d))
    return {"att": theta, "se": se, "rmse_mu0": rmse, "propensity_acc": acc}


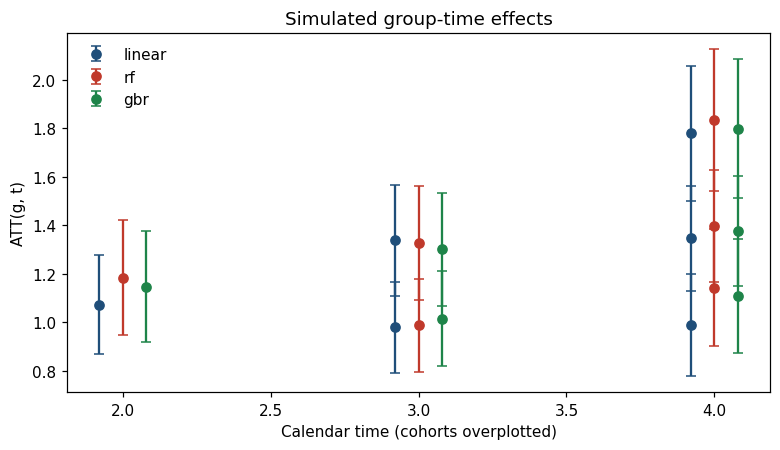
def simulate_panel(n_units=700, seed=0):
    rng = np.random.default_rng(seed)
    cohort = rng.choice([0, 2, 3, 4], size=n_units, p=[0.45, 0.2, 0.2, 0.15])
    x = rng.normal(size=(n_units, 2))
    rows = []
    for period in (1, 2, 3, 4):
        treated_now = ((cohort > 0) & (period >= cohort)).astype(float)
        exposure = np.where(treated_now == 1, period - cohort, 0)
        outcome = (
            0.4 * x[:, 0]
            + 0.15 * period
            + treated_now * (1.0 + 0.4 * exposure)
            + 0.25 * x[:, 1] * treated_now
            + rng.normal(scale=0.45, size=n_units)
        )
        rows.append(pd.DataFrame({
            "id": np.arange(n_units),
            "period": period,
            "G": cohort,
            "Y": outcome,
            "treat": treated_now.astype(int),
            "x1": x[:, 0],
            "x2": x[:, 1],
        }))
    return pd.concat(rows, ignore_index=True)


print("DiD helpers ready")